A equipe produz campanhas em horas.
Cria uma landing page pela manhã, quinze anúncios antes do almoço e uma análise de mercado no fim do dia.
O volume aumentou. A velocidade também.
Mas a revisão continua demorando. A mensagem muda de uma peça para outra. O formulário captura dados que vendas não usa. A campanha promete uma coisa e a página explica outra. Quando o material chega à liderança, começa uma sequência de ajustes que ninguém havia previsto.
A IA entregou mais.
Isso não significa que entregou melhor.
O gargalo está mudando. Durante anos, o problema era produzir. Agora, em muitas operações, o problema é definir o que merece ser publicado.
No artigo sobre Vibe Marketing, tratei da nova forma de produzir com IA, com ciclos mais rápidos e uma relação diferente entre ideia e execução. Aqui, a discussão é outra.
Se produzir ficou barato, quem protege o padrão?
O próximo salto da IA no marketing não vem de um prompt mais engenhoso. Vem de um sistema que separa produção, julgamento e evidência. E que sabe onde a avaliação do artefato termina e a resposta do mercado começa.
É nesse ponto que o Gauntlet Loop merece atenção.
Não como fórmula mágica.
Como provocação de gestão.
O que é o Gauntlet Loop
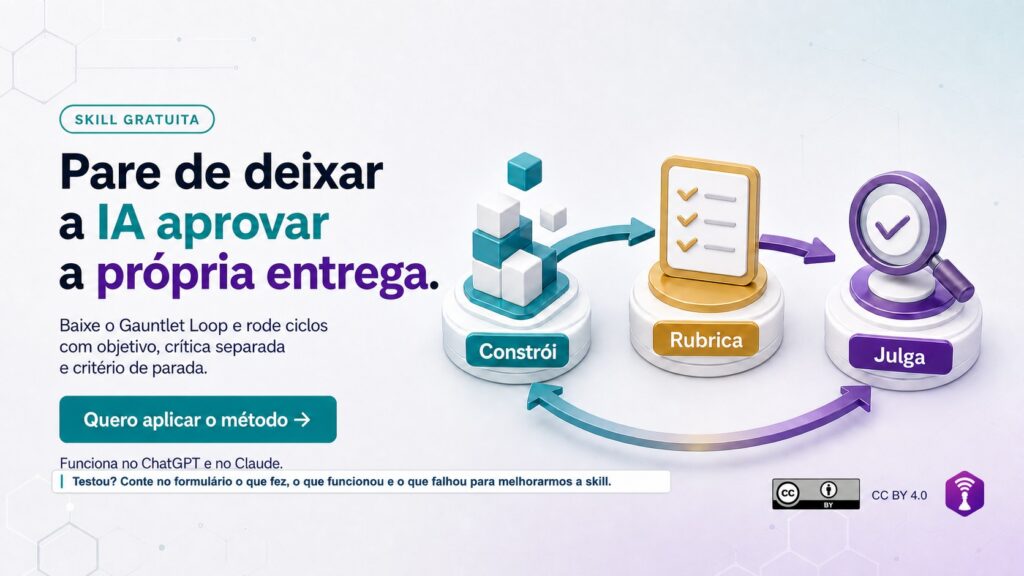
Gauntlet Loop é o nome que Matt Shumer começou a usar para descrever o processo empregado no experimento Claude of Duty, um jogo de tiro em primeira pessoa criado com uma estrutura de agentes de IA.
Segundo o relato de Shumer, um agente principal recebeu um objetivo e uma referência concreta de qualidade. Depois, dividiu o trabalho em partes menores, distribuiu a construção entre agentes e colocou cada parte diante de críticos independentes.
O processo seguiu esta lógica:
- Definir um objetivo.
- Apresentar uma referência concreta do que significa qualidade.
- Dividir o trabalho em partes que possam ser avaliadas separadamente.
- Atribuir cada parte a um agente construtor.
- Usar outro agente, com contexto separado, para avaliar o resultado.
- Comparar o artefato com a referência.
- Identificar a maior diferença.
- Corrigir e avaliar novamente.
Shumer resume o núcleo dessa dinâmica em quatro movimentos:
- dividir,
- construir,
- julgar
- e repetir.
O ponto central não está apenas na repetição. Está em impedir que o mesmo agente que produziu seja a única autoridade sobre a qualidade do próprio trabalho.
Isso não surgiu do nada.
A Anthropic já descrevia um padrão semelhante em Building Effective AI Agents, sob o nome de evaluator-optimizer.
Um modelo produz, outro avalia e o ciclo continua enquanto a revisão gerar melhoria mensurável.
Gauntlet Loop é um nome recente para uma combinação específica dessas ideias, ampliada por decomposição do trabalho, referência externa e múltiplos agentes.
Não é uma metodologia cientificamente consolidada.
Não há base para tratá-la como garantia de resultado.
O próprio experimento ajuda a conter o hype.
No relato de avaliação publicado no repositório, o objetivo era igualar a qualidade visual de um Call of Duty moderno. Isso não aconteceu.
As notas dos críticos passaram por 3,59, 4,14, 4,05 e 5,05 em uma escala de dez.
Duas capturas de tela chegaram à classificação “close”.
As demais permaneceram classificadas como “amateur”. Nas comparações cegas, os críticos escolheram as imagens do jogo original em todas as rodadas.
Houve melhoria parcial.
Não houve vitória sobre a referência.
No relato publicado, o artefato melhorou ao longo das rodadas.
O caso sugere que comparação e crítica podem ajudar, mas não isola a causa da melhoria nem comprova eficácia geral.
Também não demonstra que agentes autônomos conseguem alcançar qualquer padrão, em qualquer contexto, apenas porque permanecem trabalhando por mais tempo.
O que realmente muda para a liderança?
A leitura superficial do Gauntlet Loop é que a IA ficou mais autônoma.
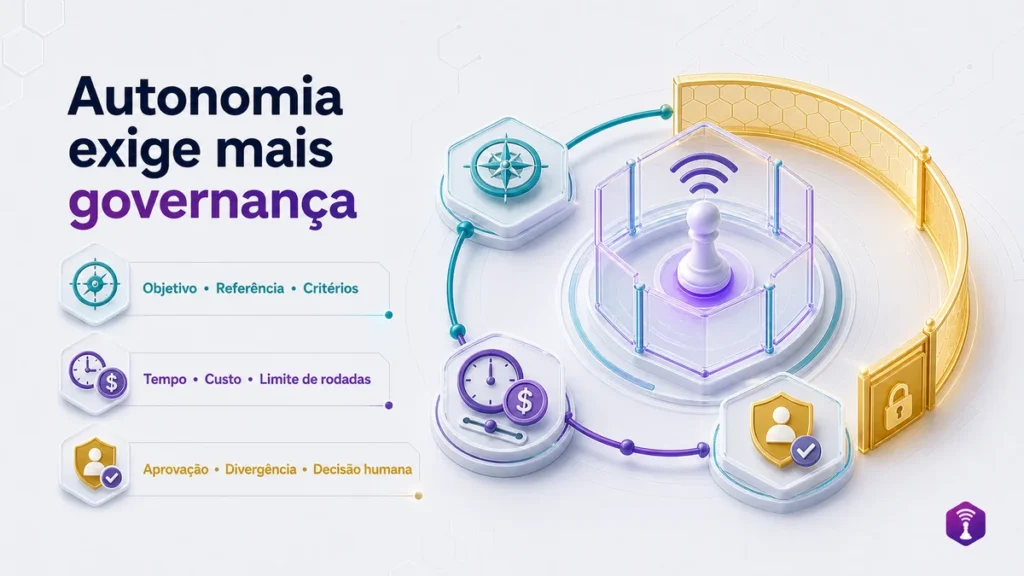
A leitura útil é que autonomia exige mais governança.
O humano pode deixar de revisar cada detalhe de cada versão.
Mas continua responsável por decisões que o agente não deveria tomar sozinho:
- Qual é o objetivo real.
- Qual referência representa qualidade.
- Quais critérios não podem ser violados.
- Quanto tempo e dinheiro o processo pode consumir.
- Quando a melhoria deixou de justificar outra rodada.
- Quem aprova a publicação.
- O que acontece quando os avaliadores discordam.
Autonomia sem referência produz volume.
Referência sem limite pode produzir uma conta infinita.
No texto original sobre o Gauntlet Loop, Shumer defende que o ciclo continue até o resultado atingir o padrão ou até uma pessoa decidir interrompê-lo. Isso pode fazer sentido em um experimento.
Dentro de uma empresa, é insuficiente.
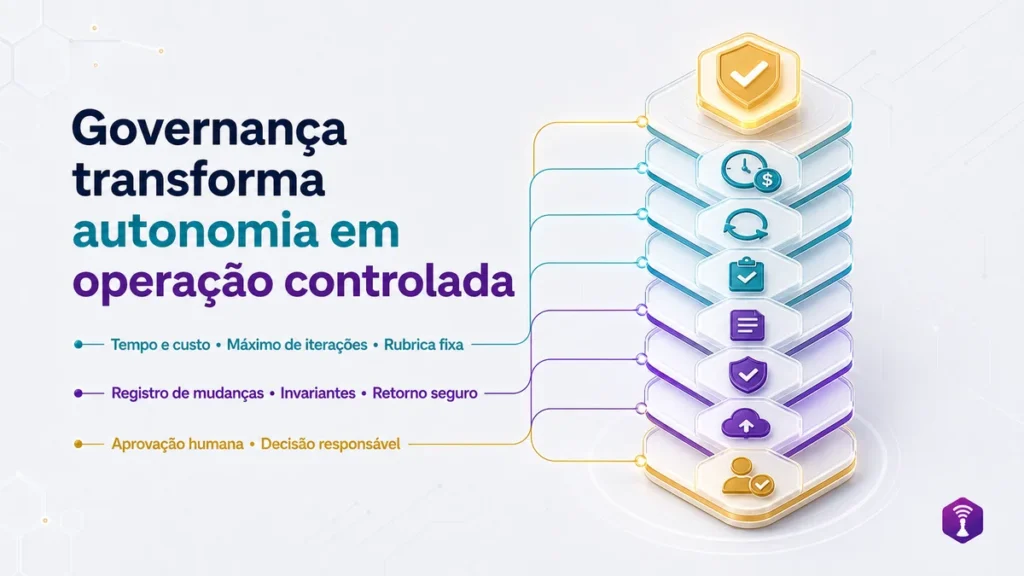
Minha adaptação para uma operação real adiciona controles que não devem ser opcionais.
Teto de tempo e custo
Cada ciclo precisa de orçamento, prazo e limite de consumo. A quinta rodada pode melhorar o artefato. Também pode custar mais do que essa melhoria vale.
Rubrica fixa
Os critérios precisam existir antes da avaliação. Se a rubrica muda toda vez que o agente encontra uma dificuldade, o sistema não está melhorando. Está movendo a linha de chegada.
A liderança pode recalibrar a rubrica entre rodadas, desde que registre a mudança e reinicie a comparação sob o novo critério.
O agente não deve alterá-la sozinho para facilitar a própria aprovação.
Máximo de iterações
Mesmo com um teto financeiro, vale estabelecer um número inicial de rodadas. Se o resultado não convergir, a tarefa volta para decisão humana.
Registro de mudanças
Cada rodada precisa mostrar o que mudou, por que mudou e qual critério justificou a alteração. Sem histórico, você não tem aprendizado. Tem apenas versões.
Invariantes
Marca, compliance, requisitos legais, segurança, proposta de valor e regras comerciais precisam ser tratados como limites. Um agente não pode sacrificar uma exigência obrigatória para ganhar pontos em estética ou conversão prevista.
Retorno seguro
Se uma rodada piorar o resultado, a equipe precisa recuperar a última versão aprovada. Evolução sem capacidade de retorno é risco operacional.
Aprovação humana
A IA pode recomendar que o ativo está pronto.
A decisão de publicar, disparar, investir orçamento ou alterar o objetivo continua com uma pessoa responsável.
O papel da liderança não desaparece. Ele sobe de nível.
Sai da correção de frase e entra na definição do sistema que decide o que é aceitável.
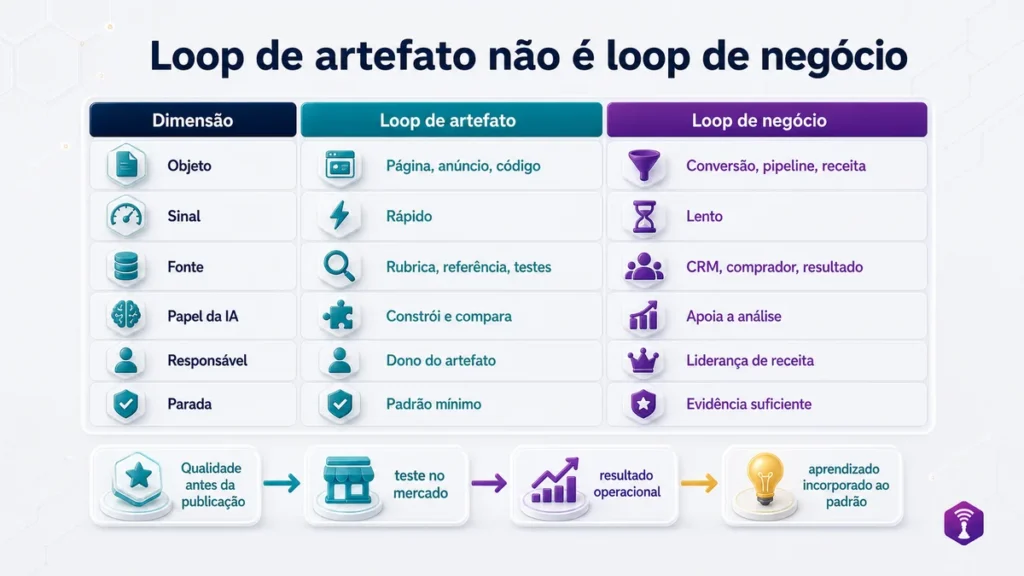
Loop de artefato não é loop de negócio
Aqui está a separação mais importante.
Um agente consegue avaliar uma landing page antes da publicação.
Pode verificar clareza, consistência, aderência à marca, funcionamento do formulário e presença de provas.
Mas ele não consegue, olhando apenas para a página, concluir que ela vai gerar pipeline.
Isso só aparece depois que compradores reais interagem com o ativo e o processo comercial registra o que aconteceu.
Dimensão | Loop de artefato | Loop de negócio |
Objeto avaliado | Página, anúncio, código, relatório ou análise | Conversão, MQL para SQL, pipeline, ciclo e receita |
Velocidade do sinal | Rápida, antes ou logo após a produção | Lenta, depois da exposição ao mercado |
Fonte de comparação | Rubrica, referência, testes e requisitos | CRM, comportamento do comprador e resultado comercial |
Papel da IA | Construir, inspecionar, comparar e sugerir correções | Apoiar análise e identificação de padrões |
Responsável final | Dono do artefato | Liderança de marketing, vendas e receita |
Critério de parada | Padrão mínimo atingido dentro dos limites | Evidência suficiente para manter, ajustar ou interromper |
O fluxo completo fica assim:
qualidade antes da publicação → teste no mercado → resultado operacional → aprendizado incorporado ao padrão
A primeira parte reduz erros evitáveis.
A segunda mostra se o ativo funciona no sistema real.
Confundir as duas cria uma nova versão do problema antigo.
- A equipe otimiza o que consegue medir rapidamente e chama isso de resultado.
- Um anúncio pode receber nota alta de um avaliador e atrair o público errado.
- Uma landing page pode cumprir toda a rubrica e gerar leads que não avançam.
- Um relatório pode estar impecável e apoiar uma decisão ruim porque partiu de dados incompletos.
O Gauntlet Loop não gera receita.
Degasperi, Israel
Ele pode aumentar a confiabilidade dos ativos que influenciam o sistema de receita. A diferença parece pequena na frase, mas é enorme na gestão.
Existe uma versão econômica desse mesmo argumento.
Rodar IA ficou mais barato, e isso não resolve nada sozinho: custo menor só torna mais barato manter um sistema que não converte.
Tratei desse ponto, com os números das próprias empresas de IA, em aquisição sem receita.
Um exemplo B2B: a landing page de campanha
Imagine uma empresa B2B lançando uma campanha para decisores de operações.
O objetivo não deveria ser apenas “criar uma landing page de alta conversão”. Isso é genérico e abre espaço para otimização de uma métrica isolada.
Um objetivo melhor seria:
“Criar uma landing page para diretores de operações de empresas com mais de 200 funcionários, capaz de comunicar o problema, apresentar prova verificável, coletar os dados necessários para qualificação e transferir corretamente o contato ao CRM.”
O trabalho pode ser dividido em quatro blocos:
- Promessa principal.
- Prova e sustentação.
- Formulário e qualificação.
- Passagem de dados para o CRM.
O agente construtor cria a primeira versão.
O crítico recebe a página, a referência é uma rubrica.
Ele avalia:
- A mensagem está alinhada ao ICP?
- A promessa é específica ou poderia pertencer a qualquer empresa?
- As provas sustentam a promessa?
- A hierarquia permite entender a oferta rapidamente?
- O formulário captura os campos usados por vendas?
- Consentimento, privacidade e requisitos de marca foram respeitados?
- Origem, campanha e demais informações chegam corretamente ao CRM?
- Existe alguma contradição entre anúncio, página e abordagem comercial?
Se o ativo falhar, volta para correção.
Se atingir o padrão, segue para aprovação humana.
O juiz de IA termina aqui.
Antes de publicar, a equipe registra a taxa de aprovação interna e a quantidade de retrabalho.
Depois da publicação, começa outro ciclo.
Agora, os sinais são:
- Conversão da página.
- MQL para SQL.
- Custo por oportunidade.
- Pipeline influenciado.
- Receita, respeitando o ciclo de venda.
Essa leitura precisa conversar com CRM e RevOps.
Se marketing celebra a conversão do formulário enquanto vendas descarta quase todos os contatos, o artefato passou no teste errado.
É o mesmo problema que aparece quando a aquisição não vira receita.
Não falta lead.
Falta conexão entre entrada, qualificação, CRM, pipeline e resultado.
Ver documentação pública no GitHub
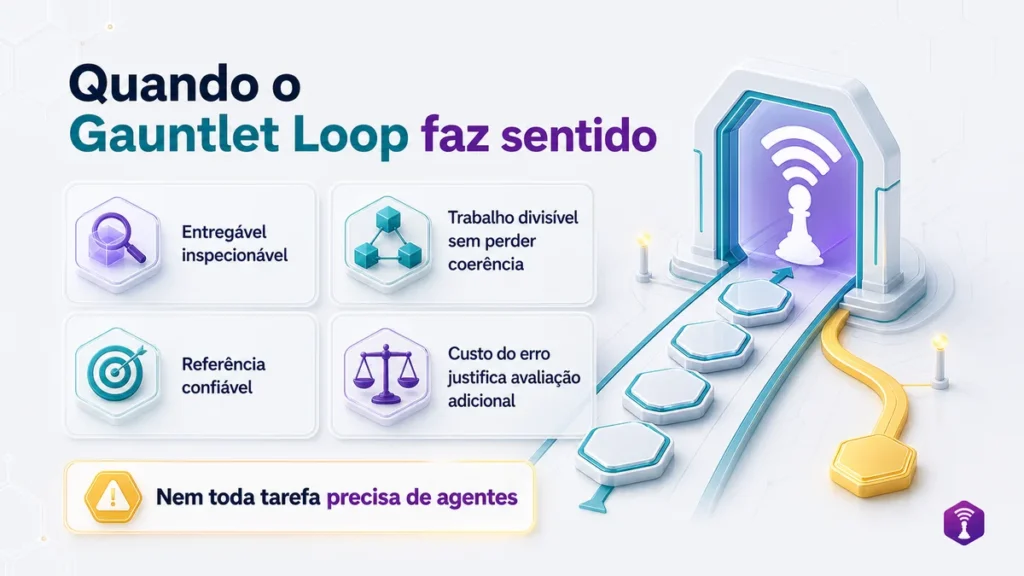
Quando o Gauntlet Loop faz sentido
O método tende a ser útil quando o trabalho tem quatro características:
- O entregável é material e pode ser inspecionado.
- O objetivo pode ser dividido sem destruir a coerência do todo.
- Existe uma referência ou uma rubrica confiável.
- O custo do erro justifica uma avaliação adicional.
Páginas, campanhas, relatórios, análises, fluxos de automação e materiais comerciais podem se beneficiar desse modelo.
Mas nem toda tarefa precisa de um sistema de agentes.
Uma alteração simples pode custar menos se for feita e revisada diretamente por uma pessoa.
A própria Anthropic recomenda começar pela solução mais simples e aceitar mais complexidade apenas quando o ganho esperado justificar custo e latência.
Também evitaria o Gauntlet Loop quando:
- A decisão é irreversível.
- Não existe referência confiável.
- Os critérios são predominantemente políticos ou subjetivos.
- O agente teria acesso para publicar ou alterar sistemas críticos sem aprovação.
- O custo de coordenação supera o valor do ativo.
Há ainda limites menos óbvios.
Um avaliador pode carregar os mesmos vieses do construtor.
Uma rubrica ruim pode transformar conformidade em falsa qualidade.
Partes melhoradas separadamente podem formar um todo inconsistente. E, quando uma métrica vira alvo, o agente pode aprender a melhorar a nota sem melhorar o que realmente importa.
O repositório do Claude of Duty mostra um exemplo relevante.
Segundo a análise publicada, rodadas paralelas com agentes responsáveis por partes isoladas geraram conflitos em elementos interdependentes.
Uma passagem sequencial, com um responsável por cada preocupação acoplada, produziu avanço maior.
Dividir ajuda.
Fragmentar sem entender as dependências atrapalha.
Como testar sem transformar o teste em projeto infinito
Não comece por uma campanha inteira.
Escolha um ativo recorrente, relevante e fácil de inspecionar.
Pode ser uma landing page, um relatório semanal, uma sequência comercial ou um briefing de campanha.
Depois, rode um piloto governado:
- Defina o objetivo. Escreva o resultado esperado sem prescrever cada detalhe da execução.
- Fixe a referência. Use um exemplo real, uma versão aprovada ou um conjunto verificável de requisitos.
- Escreva a rubrica. Limite a cinco ou sete critérios que realmente definem qualidade.
- Separe construtor e crítico. Quem produz não deve ser a única fonte de avaliação.
- Defina os limites. Estabeleça custo, tempo, número de rodadas e situações que exigem intervenção humana.
- Escolha o critério de parada. Determine a nota mínima e quais falhas impedem publicação.
- Registre as rodadas. Mantenha versão, crítica, mudança e resultado.
- Aprove antes de publicar. A decisão final precisa ter dono.
- Meça no mercado. Escolha uma métrica de qualidade operacional e uma métrica de negócio.
- Atualize o padrão. O que o mercado ensinar deve voltar para a próxima rubrica.
Essa sequência se conecta a uma lógica simples de gestão:
- Detectar o principal risco do ativo.
- Direcionar com referência e critério.
- Executar com construção, crítica e correção.
- Crescer usando a resposta do mercado para melhorar o sistema.
Sem essa última etapa, o loop fica preso dentro da própria IA.
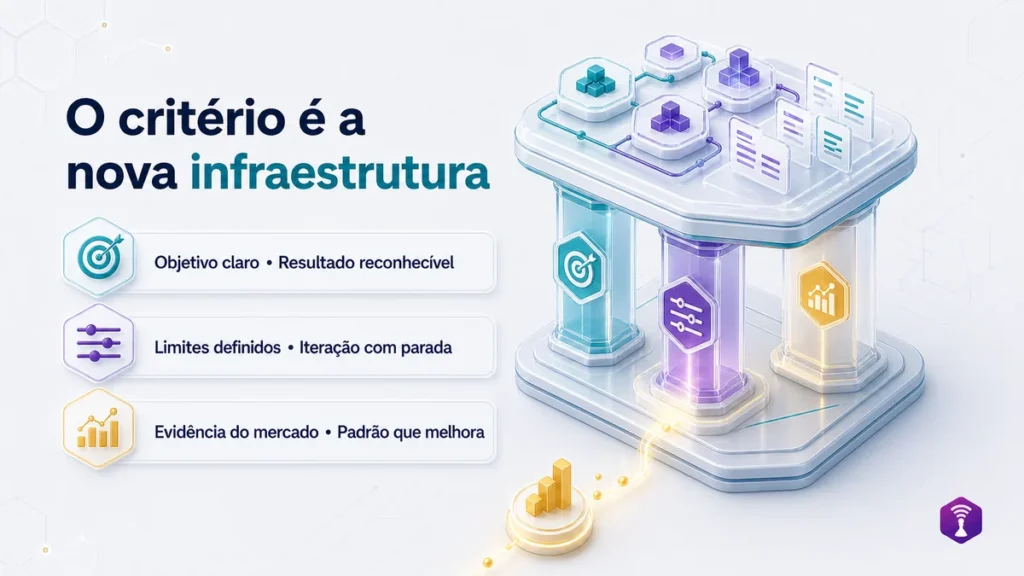
O critério é a nova infraestrutura
Durante muito tempo, empresas trataram qualidade como algo que uma pessoa experiente percebia ao revisar o trabalho.
Isso funcionava quando o volume era menor.
Com agentes de IA produzindo em escala, critério precisa sair da cabeça de alguém e entrar no sistema.
Não para eliminar julgamento humano.
Para usá-lo onde ele é mais valioso.
A discussão sobre IA nas empresas está excessivamente concentrada no modelo, no prompt e na ferramenta. Mas uma operação não se torna mais inteligente porque produz vinte versões em vez de duas.
Ela se torna mais inteligente quando sabe:
- O que está tentando alcançar.
- Como reconhecer um bom resultado.
- Quais limites não podem ser ultrapassados.
- Quando interromper a iteração.
- Qual evidência deve vir do mercado.
- Como transformar essa evidência em um padrão melhor.
Isso também vale para a liderança de Growth B2B.
Liderar não é acompanhar cada execução.
É manter a leitura do sistema clara o suficiente para que velocidade não destrua controle.
Hoje, quem define o que é bom no trabalho da sua IA: um critério verificável ou o próprio agente que produziu?
Escolha um único ativo recorrente e rode o piloto. Não aumente a autonomia antes de aumentar a capacidade de avaliar.
Se o problema for maior do que um ativo e estiver na conexão entre marketing, CRM, vendas e decisão, o gargalo não é a IA. É o sistema de receita que ela está acelerando.
O Radar de Growth é um diagnóstico gratuito que mapeia onde sua aquisição, CRM e pipeline estão perdendo eficiência. Leva menos de 2 minutos, em 4 etapas curtas de seleção. O resultado chega por email com um resumo do que precisa de atenção primeiro.