Seis a dez prompts representativos.
É assim que a maioria dos frameworks de AI Search resume o processo de medição, inclusive o meu, quando o texto precisa caber num H2 de um artigo mais amplo.
Na prática, é pouco.
Dez prompts genéricos testam um território só, e a presença em IA muda de território para território dentro da mesma marca.
Testei a minha própria operação contra vinte prompts divididos em quatro territórios diferentes.
Em dois deles, recomendação direta e primeira posição. Em outros dois, zero menção e uma lista de concorrentes no lugar do meu nome.
Se eu tivesse parado nos primeiros dez, a leitura teria sido incompleta, para o lado bom ou para o lado ruim, dependendo de qual metade eu tivesse testado primeiro.
O problema não é testar pouco. É testar sem território definido e achar que uma amostra pequena representa a marca inteira.
Os quatro territórios que uma bateria precisa cobrir
Antes de abrir o ChatGPT, defina onde você está testando. Uma bateria útil cruza pelo menos quatro tipos de pergunta.
A categoria genérica em que sua empresa compete: “consultoria de growth B2B”, “agência de performance para SaaS”. É o território mais disputado e, para a maioria das marcas, o mais fraco. Testar só nele e generalizar para “presença em IA” é o erro mais comum que vejo.
O problema nomeado sem a sua marca: “como conectar CRM, aquisição e pipeline”, “por que meus leads não viram receita”. Aqui a IA não está procurando um fornecedor, está respondendo uma dor. Presença nesse território é mais fácil de conquistar e mais difícil de perceber, porque não aparece como recomendação direta, aparece como citação de fonte.
A comparação direta com formato de concorrência: “consultoria boutique versus agência tradicional”, “consultor independente ou parceiro de ferramenta”. Território de decisão, onde a IA já assumiu que o leitor vai contratar alguém e está ajudando a escolher o formato.
A tese ou metodologia proprietária que você defende publicamente: o argumento específico que você repete em conteúdo, não o nome genérico da categoria. Testei “autores que defendem que o problema não é o canal” e a IA me reconheceu direto, pela tese, não pela categoria “especialista em growth B2B”. Esse território costuma ser o mais forte de qualquer marca com conteúdo consistente, e o menos testado, porque ninguém pensa em testar a própria tese como prompt.
Cinco prompts por território, vinte no total, já é suficiente para enxergar padrão. Menos que isso e você está de volta ao teste anedótico.
Três níveis, não um resultado binário
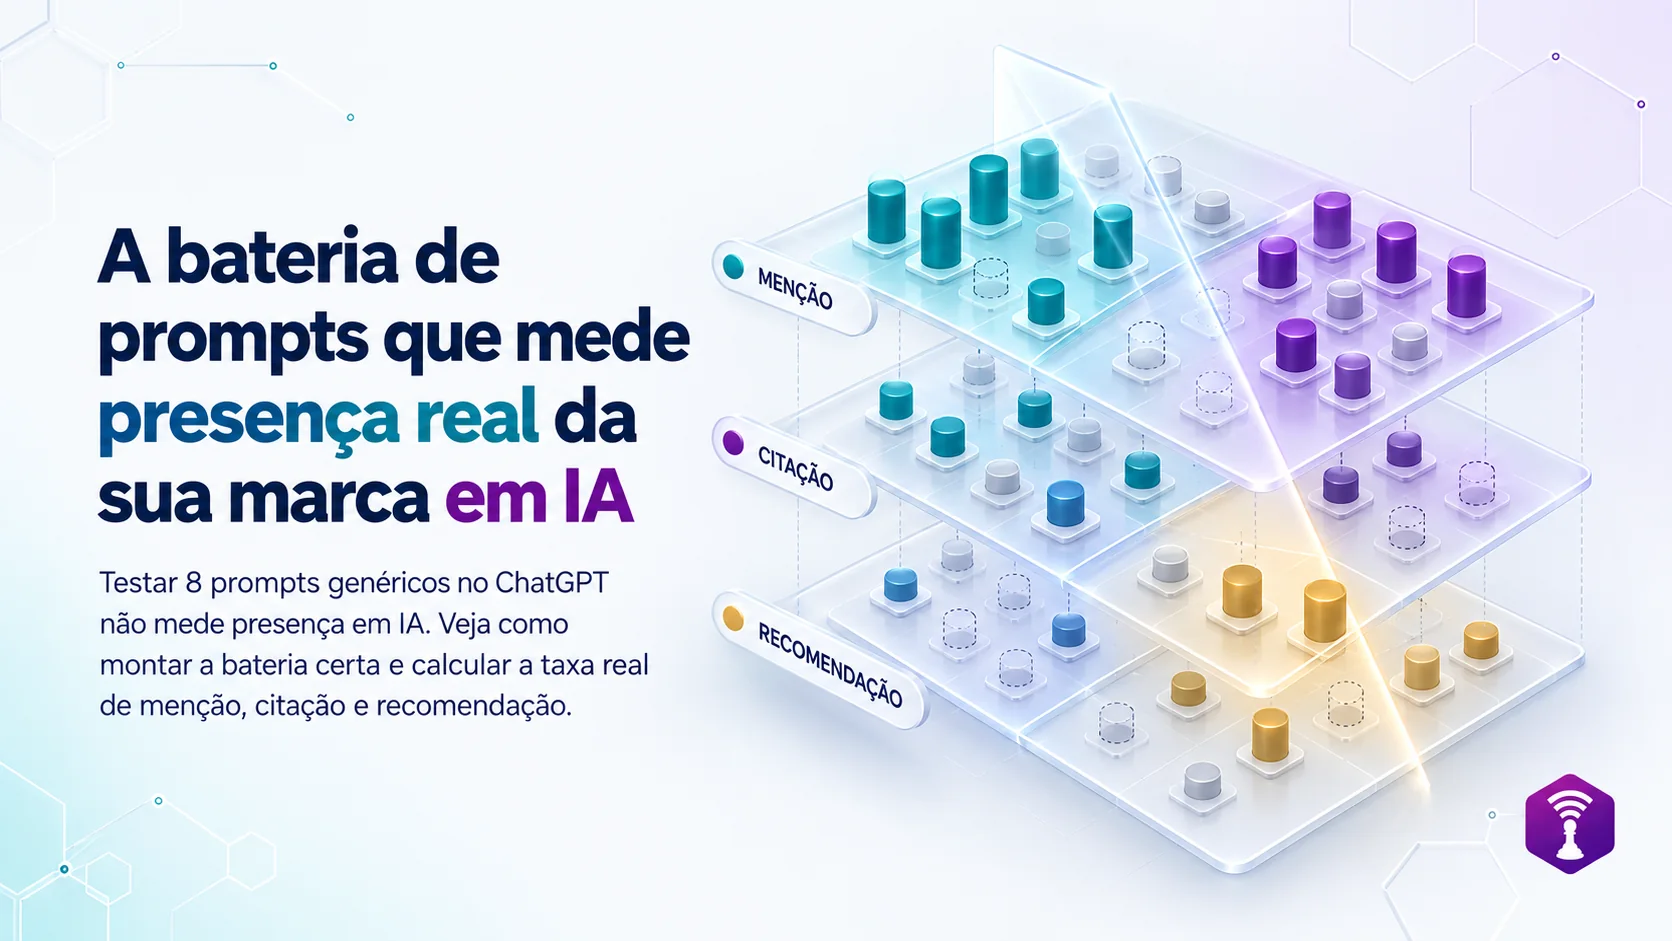
Cada resposta da IA precisa ser lida em três camadas separadas, não como “apareceu” ou “não apareceu”.
Menção é o nome da marca aparecer em algum ponto da resposta, mesmo secundário.
Citação é a IA referenciar seu domínio ou seu conteúdo como fonte, sem necessariamente recomendar.
Recomendação é a marca aparecer como resposta ao problema do leitor, no topo ou no shortlist.
As três camadas raramente se movem juntas.
No meu próprio teste, os territórios de tese e metodologia geraram citação e recomendação. Os territórios de categoria genérica geraram menção quase nula e, quando apareceu, veio no meio de uma lista de concorrentes recuperados pela IA, sem destaque nenhum.
Registrar cada resposta como um resultado só, sem separar as três camadas, esconde exatamente a informação que decide o que fazer a seguir.
Ser citado com frequência e recomendado quase nunca é um problema de vocabulário de categoria. Não ser nem mencionado é um problema mais estrutural, de conteúdo ou de entidade.
Como calcular a taxa sem inflar o resultado
Depois de rodar a bateria, o erro seguinte é contar em vez de calcular a taxa.
A taxa de menção, citação e recomendação se calcula sobre o total de prompts efetivamente testados, não sobre o total planejado.
Numa bateria de vinte prompts em que treze já rodaram, a taxa é sobre treze. Os sete pendentes ficam marcados como pendentes até serem testados, nunca contados como negativo por omissão, e nunca contados como positivo por otimismo.
Cada prompt precisa rodar em pelo menos dois motores antes de virar dado. ChatGPT e Perplexity como par mínimo, Gemini e AI Overviews quando o volume do setor justificar.
Testar só um motor e generalizar para “IA” é o mesmo erro de testar dez prompts do mesmo território e generalizar para a marca inteira.
E a bateria não se roda uma vez.
Modelo muda, índice muda, concorrente publica algo que desloca a resposta.
Uma bateria testada em agosto e nunca mais revisitada é a fotografia de um momento que já passou, sendo usada para decidir prioridade de conteúdo hoje.
Retestar a cada seis a oito semanas é o mínimo para a taxa continuar significando alguma coisa.
Sinais de que sua bateria não está medindo nada de verdade
Ninguém no time sabe dizer quantos prompts diferentes testaram esta semana. Se a resposta é “testamos outro dia no ChatGPT”, no singular, não existe bateria.
Os resultados estão registrados como “apareceu” ou “não apareceu“, sem separar menção, citação e recomendação.
Só um motor foi testado e está sendo tratado como representativo de toda a IA generativa.
A entidade pessoal do fundador ou porta-voz nunca foi testada separada da entidade da empresa. As duas têm níveis de presença diferentes, e sem testar as duas você não sabe qual precisa de trabalho.
Você sabe dizer, hoje, em qual dos quatro territórios sua marca é recomendada e em qual ela nem aparece?
E sabe se essa resposta ainda vale, ou é de um teste que ninguém repetiu desde então?
Se você se identifica ou está passando por este momento na sua empresa, a Análise de Presença em AI Search mapeia esses quatro territórios nos motores que importam para o seu mercado (ChatGPT, Gemini, Perplexity, Google AI Overviews) e mostra em qual camada, menção, citação ou recomendação, sua marca está travada.